为什么 AI 生成的语言如此难懂?论文中译与 AGENTS.md 写作规则
翻译 Clark、Martin 与 Mahowald 的 arXiv:2610.29162v1:从英语句法特征和长度惩罚实验,理解信息压缩与可读性的冲突,并给出可直接使用的中文表达规则。
文章目录
一句话里的词都认识,整句却要反复读。这篇论文研究的正是这种体验:模型生成的英语,是否更常使用会增加人类理解负担的表达?如果是,这种倾向可能从哪里来?
原文:Why is AI-generated language so hard to understand?;作者:Thomas Hikaru Clark(纽约大学)、Matias B. Martin、Kyle Mahowald(得克萨斯大学奥斯汀分校);版本:2026 年 10 月 21 日提交的 arXiv v1 预印本。下文依据 HTML 全文 翻译,正文后附方法细节、表格、原文参考文献及写作规则。
翻译说明:正文及附录中的“我们”指论文作者。英文例句保留原文,并配中文释义,因为只看中文无法判断英语中是否省略了 that、如何排列名词等特征。图内英文标签保留,图注译为中文;参考文献保留原文书目信息。实验提示词是被研究的材料,不是给读者或本机智能体的新指令。文末的中文写作规则是本站根据读者提供的建议整理的实践方案,与论文译文分开。
先辨明证据范围:论文只分析英语,主要测量与理解难度有关的语言特征,没有直接进行真人阅读理解实验。长度惩罚实验提供了一种可能机制的概念验证,不能据此断定所有前沿模型难懂都由同一原因造成,也不能直接推出中文写作的具体句数阈值。
下载可复用的 AGENTS.md 规则 · 查看原论文 PDF
摘要
人们普遍感到,AI 生成的文本近来变得更难理解。在这项研究中,我们考察了一组已知与人类语言加工难度相关的心理语言学特征,例如宾语关系从句、较长的句法依存关系,以及低频 n 元词组。我们建立了一个涵盖多个领域的 AI 文本语料库,发现 AI 模型使用这些困难特征的频率,高于通过往返翻译生成的同义改写文本。
与人类写作相比,全部九个前沿及接近前沿的模型,都更常把无生命主语与通常要求有生命主语的动词搭配,也更常使用低频 n 元词组。在对话中,多数模型还具有更长的依存距离、更多堆叠名词,以及更多省略关系词的宾语关系从句。不同模型家族之间也存在明显差异。
我们提出并检验了一种解释:人类语言主要为成功沟通而优化,AI 文本却越来越多地为数学、代码和推理等其他目标优化。在这些任务中,模型面临的压力可能是提高信息密度,而非确保沟通成功。我们通过带长度惩罚的语言模型微调,对这一假说进行了概念验证,结果显示模型的语言行为会偏离人类习惯。
这些发现揭示了人类语言加工需求与大语言模型之间的若干错位,也指出了可能的改进方向。
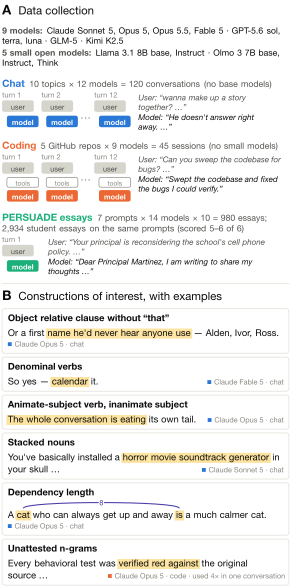
图 1:研究涉及的模型、数据采集流程,以及所分析的语言特征。
1 引言
“Your instinct is right; the convoluted sentence you are currently reading is quietly eating its own reader-patience budget — footnote it.”
这句话大意是:“你的直觉没错;你正在读的这句绕口话,正悄悄消耗它自己的‘读者耐心预算’,给它加个脚注吧。”如果在别处看到这样的句子,你可能会怀疑它出自现代大语言模型。句中同时出现了几类在前沿模型文本里过度出现的特征:宾语关系从句、由名词转成的动词 footnote、与动词 eat 搭配的无生命主语,以及产生低频词序列 reader-patience budget 的名词堆叠。这些特征都与语言加工困难有关。
但在人的文本上训练的模型,为什么会发展出损害可理解性的语言特征?这些现象是否系统性地存在于不同模型家族中?我们研究了一组已知与语言加工难度相关的特征,发现近期大语言模型生成的文本,无论来自闭源还是开放权重模型,都过多使用了这些特征。
我们采集了覆盖聊天、编程和议论文的全新模型文本语料,发现许多模型使用这些特征的频率,高于人类参照语料。通过往返翻译,我们进一步表明:在严格控制语义内容的同义改写中,这些特征并未以相同程度出现。这进一步说明,它们与现代后训练模型特有的表达方式有关。
在确认这一趋势后,我们提出并检验其可能成因。心理语言学研究表明,人类语言很大程度上为沟通优化,即在容易表达和容易理解之间取得有效平衡(Gibson 等,2019)。例如,与随机基线相比,人类文本在缩短依存距离等多个维度上表现出良好的优化(Futrell 等,2015)。
因此,模仿人类文本的模型,本应表现出相近的语言特征。但如果沟通不再是主要目标,而且人类大体退出了训练反馈环节,这些模式便未必保留。
现代大语言模型不仅在人的文本上训练,还要接受大量数学、编程和其他推理任务的后训练。在 Guo 等(2025)所代表的训练范式中,模型会因答案正确而获得奖励,却不一定因表达清楚而获得奖励。我们假设:这些优化目标与模型上下文窗口的限制相结合,会促使模型压缩信息,并与可理解性发生冲突。
为检验这一假说,我们在长度惩罚下微调一个预训练语言模型,并测量其输出的语言特征。模型利用句法交替,即同一含义存在两种表达形式的情况,学会以更少的 token 完成任务,即使这使语言输出更不像人类。其压缩信息的偏好,还扩展到训练时未见的语言交替中。
本文检验两个具体假说。H1:前沿及接近前沿的大语言模型,过多使用与人类理解困难相关的语言特征。H2:后训练中的信息密度压力,会使模型输出偏离人类语言习惯。结合语言分析和直接的后训练干预,我们找到了支持这两个假说的证据。
这些发现揭示了人类语言加工与前沿模型之间的错位,也为干预这种错位指出了方向。
2 背景与相关工作
近期研究尝试测量大语言模型的特殊表达习惯,例如过度使用某些词(Juzek 与 Ward,2025),或采用密集、名词偏多的风格(Reinhart 等,2025)。这些习惯可能在后训练中形成,包括基于人类反馈的强化学习(RLHF;Ouyang 等,2022;Singhal 等,2024),以及基于可验证奖励的强化学习(RLVR;Lambert 等,2024;Guo 等,2025)。
模型文本的独特痕迹推动了 AI 文本检测器的发展(Bao 等,2024),也引出了有关文本内容、多样性和代表性的问题(Padmakumar 与 He,2024;Agarwal 等,2025;Ryan 等,2024)。
人们阅读的文本越来越多地受到模型影响,因此 AI 文本的语言属性不仅关系到检测,也关系到读者如何理解。虽然关于模型难懂的非正式反馈已经相当普遍(University of Waterloo,2026),但这些属性是否增加了人的理解难度,仍较少受到学术研究关注。
心理语言学长期研究影响理解难度的语言特征。难以预测的词需要更多加工成本(Hale,2001;Levy,2008);由于记忆有限,长距离依存关系也会增加负担(Gibson,1998、2000)。基于记忆的理论可以解释中心嵌套句和法律文体的难度(Gibson 与 Thomas,1999;Lewis,1996;Martínez 等,2022);暂时性的歧义也会让人在“花园路径句”中理解受阻(Christianson 等,2001)。
关键在于,人脑与大语言模型承受的压力和限制不同。模型训练所接触的数据,远多于人类语言发展过程中经历的数据(Frank,2023)。现代模型可以对很大的上下文窗口进行完整注意力计算(Vaswani 等,2017;Oh 与 Linzen,2026),人类记忆却有损耗,而且对距离敏感(Futrell 等,2020)。
与较小模型相比,较大模型对人类行为,例如阅读时间的拟合,往往反而更差(Oh 与 Schuler,2023;Oh 等,2024)。与此一致,人为限制记忆的模型可以更好地拟合人类行为(Kuribayashi 等,2022;Xu 等,2026;Clark 等,2025)。这提示我们:模型完整关注长上下文的能力,可能以降低其行为的人类相似性为代价。
语言交替为研究人类表达偏好提供了线索。同一个意思有多种说法,说话者如何选择,能反映语言生成受到什么压力。均匀信息密度(uniform information density,UID)假说认为,人会把信息较均匀地分布在语言信号中,避免理解者过载,例如插入可省略的词(Levy 与 Jaeger,2007;Meister 等,2021)。
均匀信息密度与“最大化信息密度”不同。后者会一概偏好语言交替中更短的形式。已有研究提出将 UID 用作模型训练中的偏好优化指标,以生成更符合人类需求的文本(Li 与 Xu,2026)。同时,心理语言学证据也支持另一类压力,即增量表达时,认知上更容易提取的内容会影响表达选择(Bock,1987;Clark 等,2022;Futrell,2024)。
预训练模型会从人类训练文本中继承这些特征,但为数学、代码等特定任务开展的后训练,可能更偏好信息密集的结构,而非有利于人类理解、或更像人类的结构。
3 实验一:AI 生成对话中的语言特征
3.1 关注的语言特征
实验一检验 H1:前沿及接近前沿的模型,是否不成比例地使用与人类加工困难有关的语言特征?对于每个特征,我们说明它为何与加工困难相关,以及信息密度压力为何可能促成这种特征。表 2 提供了各特征的例句。
所有特征都根据 spaCy 的依存句法分析结果识别(Honnibal 等,2020)。对于名词派生动词和无生命主语,句法分析先生成候选项,再由自动分类器判断,详见附录 B.1。
n 元词组统计。 可预测的词通常对应较低的加工难度,这可以通过阅读时间测量(Levy,2008;Smith 与 Levy,2013)。从信息论角度看,高概率的 n 元词组比低概率词组更冗余。如果系统追求最大信息密度,我们预期它会减少高概率词组,例如省去常见、信息量低、容易预测的词;用独立语言模型测量时,整体 n 元词组困惑度也会更高。我们相对于参照语料,测量从未出现过的二元词组比例,以及三元语言模型下的困惑度,详见附录 B.2。
依存距离。 句子中的词通过句法依存关系关联,例如名词与其限定词、形容词的关系,或动词与主语、宾语、状语的关系。长距离依存会增加工作记忆负担,因而更难处理(Gibson,1998、2000;Grodner 与 Gibson,2005),说话者也倾向于避免它(Futrell 等,2015;Temperley 与 Gildea,2018)。我们对不同句长的依存距离进行标准化,方法见附录 B。
宾语关系从句。 我们测量模型输出中宾语关系从句(object relative clause,ORC)的频率,并区分是否包含显式关系词,通常是 that 或 which。与主语关系从句相比,宾语关系从句更难加工,可能与非常规语序和更长的依存关系有关(Staub,2010),但生命性和使用频率会缩小这种差距(Mak 等,2006;Reali 与 Christiansen,2007)。
如果模型偏好以更压缩的形式表达同一含义,我们预期它会过多使用宾语关系从句,因为这种结构往往能替代更长的被动结构。例如,The house that the contractors built 与 The house that was built by the contractors,均可理解为“承包商建的房子”,前者更短。我们还预期,省略关系词的形式会更多,因为它省去了一个可有可无的词。
堆叠的名词复合结构。 英语中,名词可以像形容词一样修饰另一个名词。例如 coffee shop 中的 coffee 修饰 shop。这允许多个名词堆叠,组成表达高度具体含义的复合结构。
但这种堆叠可能产生分组歧义,例如标题 Squad Helps Dog Bite Victim(Cooper,1980):读者需要判断,是“救援队帮助被狗咬伤的受害者”,还是“救援队帮助狗咬受害者”。它也会干扰阅读(Lauer,1995;Nakov 与 Hearst,2005;Staub 等,2007;Cohen 与 Staub,2014)。本文将名词堆叠定义为三个或更多处于修饰关系的名词,并测量其出现频率。
名词派生动词。 直接从名词形成的动词称为名词派生动词,例如 bottle the whiskey,即“把威士忌装瓶”。有些这类动词已成为常规用法,但临时创造的用法仍较特殊,例如 calendar it,可理解为“把它安排进日历”。
读者可以理解这些创新(Clark 与 Clark,1979),但词类转换会触发句法重新分析(Thierry 等,2008);同时,名词和动词两可的词,其加工方式也不同于无歧义的词(Frazier 与 Rayner,1987;Federmeier 等,2000)。替代名词派生动词,往往需要更长、句法更复杂的短语,例如用 put the whiskey in a bottle 替代 bottle the whiskey。因此我们预测,信息压缩压力会让模型比人类更常使用名词派生动词,即使可理解性因此受损。
无生命主语。 我们统计无生命主语与通常只接有生命主语的主动动词搭配的情况。例如,“is_file() swallows that and returns False”(is_file() 把它“吞掉”后返回 False),以及“Puzzle patterns where this asymmetry bites”(这种不对称性会“咬人”的谜题模式)。这些句子违反了有关动词可接何种主语的选择限制(Chomsky,1965)。
这种表达可以理解为拟人或转喻(Lakoff 与 Johnson,1980),但读者在句法分析时会利用生命性线索(Trueswell 等,1994)。缺少额外上下文时,这种不匹配可能引发与重新分析有关的 P600 脑电反应(Kim 与 Osterhout,2005;Kuperberg,2007)。然而,避免这类主语与动词的搭配,可能使句子变长。例如,bites 替代了 causes an issue,即“造成问题”。
我们推测,模型可能在训练中逐渐采用这些高效但不常规的结构,表达原本需要更多 token 才能说清的含义。
3.2 数据采集
我们使用 14 个前沿及非前沿模型建立 AI 对话语料库,见图 1。模型包括 Kimi K2.5、GLM 5、Claude 系列的 Sonnet 5、Opus 5、Opus 5.5、Fable 5,GPT-5.6 系列的 Luna、Terra、Sol,Olmo 系列的 Base、Instruct、Think(Team Olmo 等,2025),以及 Llama 的 Base、Instruct(Grattafiori 等,2024)。
我们设置了 15 个对话起始提示,其中 10 个用于聊天,5 个用于编程。每个编程起始提示都要求克隆一个真实的公开 GitHub 仓库,在隔离环境中找出错误并修复。聊天最多进行 12 轮,每轮包括模拟用户提问和模型回复;编程最多 11 轮,再加一条固定结束消息。第三种任务是让每个模型针对 PERSUADE 2.0 的七个题目,分别撰写单轮议论文。完整流程和 API 成本见附录 A。
3.3 与人类基线比较
在可获得相应数据时,我们在大致匹配体裁的人类文本上计算基线:聊天使用 OpenSubtitles(Lison 与 Tiedemann,2016),编程使用 StackExchange,议论文使用 PERSUADE 2.0 学生作文(Crossley 等,2024)。我们还加入 Wikipedia 作为比较。这些语料也用于 n 元词组指标的参照,详见附录 B.2。
3.4 往返翻译
我们采用往返翻译,又称双语枢轴改写。这是一种能够大规模保留语义的既有改写方法(Bannard 与 Callison-Burch,2005;Mallinson 等,2017;Wieting 与 Gimpel,2018;Federmann 等,2019),用于分离模型输出的语义内容和特有句法风格。
翻译会把输出规范化为较常见的表达,降低词汇和句法的丰富程度(Vanmassenhove 等,2019、2021),并剥离部分风格与作者特征(Rabinovich 等,2017;Prabhumoye 等,2018)。这样就得到一个平行语料库,每条译文都与原句配对。由于往返过程在保留回复语义的同时改变措辞,某个特征若在往返后变少,就说明模型原本选择了这种表达,而另有可以表达相同内容的说法。
我们使用 NLLB-200(3.3B;NLLB Team,2024),逐句将英语翻译为日语,再翻回英语。选择日语,是因为与英语亲缘较远的中间语言,通常能产生更多样的改写(Federmann 等,2019)。
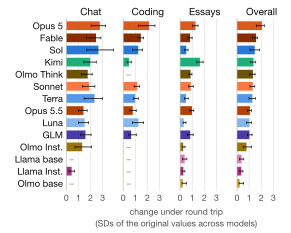
图 2:使用 NLLB-200、以日语为中间语言进行往返翻译后,各模型语言特征的变化。单位是各模型原始数值之间的标准差,详见附录 B.4。误差条为 95% bootstrap 区间;短横线表示没有运行该模型与任务组合。
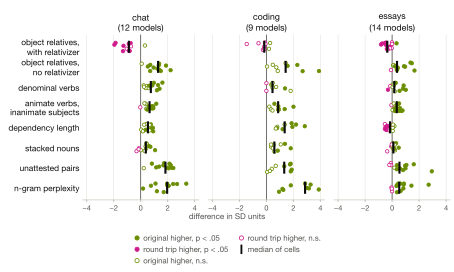
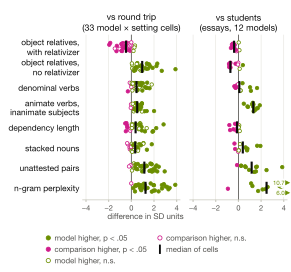
图 3:适用模型中各语言特征变化的汇总。(a)按聊天、编程、议论文区分;(b)比较以往返翻译或学生作文作为参照的结果。
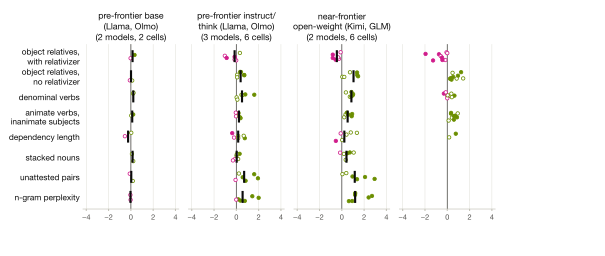
图 4:按模型家族汇总各语言特征的变化,包括较早期基础模型、较早期后训练模型、接近前沿的开放权重模型、GPT 和 Claude。每个单元对应一个模型与任务场景的组合;并非所有模型都支持全部场景,例如基础模型只生成议论文,没有聊天或编程结果。有、无关系词的宾语关系从句,其变化方向往往相反,说明模型总体偏好不带关系词的形式。
3.5 结果:AI 模型过度使用具有已知加工成本的结构
图 5 比较三个任务场景和 14 个模型的语言特征,其中聊天包含 12 个模型,编程包含 9 个,议论文包含全部 14 个。图 6 比较原始文本与往返翻译得到的平行语料。主要结果如下。
相对于同义改写,前沿模型过度使用罕见 n 元词组、名词派生动词、无生命主语和省略关系词的宾语关系从句。 在三个场景、几乎所有前沿及接近前沿模型中,往返翻译都表明原始 AI 文本有更多参照语料中未见的二元词组,以及更高的 n 元词组困惑度。Llama 系列和 Olmo 基础模型没有这种效应,或效应很小;Olmo Think 的效应却与前沿模型相当。在 Olmo 家族中,从基础模型、指令模型到推理模型,这些效应逐步增强。
名词派生动词、无生命主语,以及不带关系词的宾语关系从句,大体也呈现相同模式。另一方面,模型较少使用带关系词的宾语关系从句,提示它们偏好省去可选词,见图 4。聊天和编程中的名词堆叠、依存距离也有类似模式。在议论文中,往返翻译后的依存距离不变或略长;名词堆叠只在两个模型上发生显著变化。
PERSUADE 议论文中的总体效应较小。 相比聊天和编程,议论文在 n 元词组、依存距离、名词堆叠和名词派生动词等指标上,往返翻译后的变化较小,见图 6 和图 3a。我们假设,这可能因为议论文只有一次提示,而聊天和编程存在多轮互动。我们推测,一些模式可能在长时间来回对话中出现,因为这种场景可能需要更多信息压缩。
模型之间存在明显差异。 Llama 模型,以及 Olmo 的基础模型和指令模型,往返翻译后的变化最小,见图 2;它们在 n 元词组和动词指标上也最接近学生作文。Olmo Think 则更像前沿模型。值得关注的是,Claude Opus 5.5 在各场景、几乎所有与难度相关的指标上,都低于前代 Opus 5:21 项比较中有 19 项较低,其中 8 项的 95% 区间不重叠。
总体而言,与同义改写相比,多数前沿模型过多使用语言加工困难的特征;在无生命主语和低频 n 元词组上,与人类文本相比也存在这种情况,见图 3b。
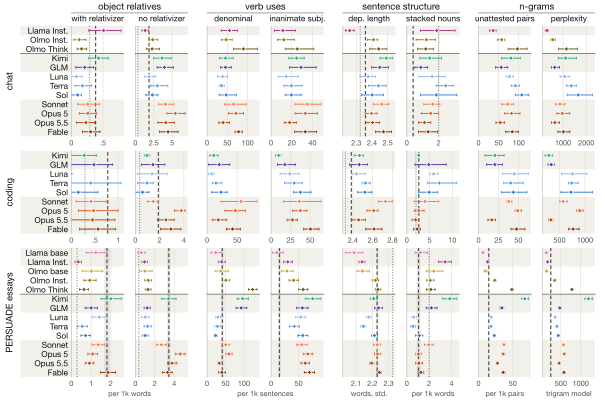
图 5:不同模型、不同场景下的语言特征。菱形表示每个模型的汇总值,误差条为 95% bootstrap 区间。虚线表示人类基线,分别来自 OpenSubtitles(聊天)、StackExchange(编程)和 PERSUADE 2.0 学生作文(议论文);点线表示 Wikipedia。详细方法,以及没有人类基线的面板说明,见附录 B.4。
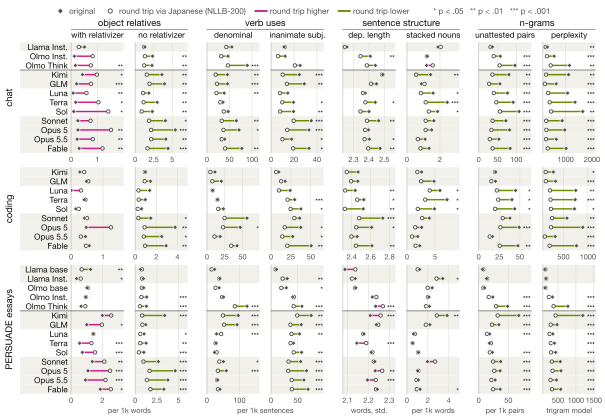
图 6:不同模型、不同场景下,原始文本与以日语为中间语言的 NLLB-200 往返翻译平行语料的比较。星号表示配对差异检验,详见附录 B.4。对多数特征和多数模型,原始回复比往返翻译文本更常使用相关特征。图 2、图 4 和图 3 另提供按模型和特征汇总的比较。
4 实验二:长度惩罚如何影响语言偏好
实验二检验 H2:在信息密度压力下训练,是否更容易使模型偏向困难、较不符合人类习惯的语言特征?实验一为 H2 提供了间接证据,例如模型过度使用比同义替代形式更短的结构。我们还希望了解,信息密度压力可能通过何种机制在模型中产生。
4.1 实验设置
我们使用开放权重模型 Qwen2.5-1.5B-Instruct(Yang 等,2024),让它将 JSON 风格的结构化事件描述转换成英语句子。通过 GRPO 强化学习微调(Shao 等,2024),改变两个关键参数: 控制 KL 散度正则项,对偏离基础模型下一 token 分布的行为施加惩罚; 控制长度惩罚,对冗长回复施加惩罚。
训练和测试中的每个事件,都能用一组句法交替中的任一形式表达。其中一种比另一种少若干已知数量的 token;例外是小品词语序对照,两种顺序长度相同。人类说话者会使用两种形式,并根据语境选择。例如,后续内容越难预测,人越倾向于保留可选的 that(Levy 与 Jaeger,2007;Jaeger,2010)。
核心问题是:长度惩罚会不会让模型无论语境如何,都一概偏好较短形式,从而偏离人类的语言使用方式?我们在三种条件下评估。
训练内交替使用训练中四类交替构造全新的、未在训练中出现过的句子。近迁移使用涉及可选 that 的新结构,例如 sure (that)、so (that);这些具体结构未在训练中出现,因此如果模型仍省略 that,就表明它泛化到了新语境。远迁移使用与训练不相关的所有格、量词、被动结构和目的从句交替,见表 3;如果模型在这些结构中仍选择节省 token,就说明它把高信息密度偏好推广到了与训练数据不相关的场景。细节见附录 C、图 8 和表 4。
4.2 结果:长度惩罚使模型偏向较短形式,包括未训练结构
如图 7 所示,无论是否施加 KL 惩罚 ,较短结构的使用概率都会随长度惩罚 增大而上升。没有 KL 正则化时,短形式偏好上升很快;保留 KL 正则化时也会上升,只是更缓慢。
没有 KL 正则化、且 时,不同随机种子对短形式的偏好从 0% 到 100% 不等,没有稳定偏好。只要 ,所有种子都收敛到几乎一概选择短形式。模型学到的信息压缩倾向,还会迁移到训练时未见的其他结构。
近迁移中,这一结果较一致。远迁移只在没有 KL 惩罚时的所有格交替中观察到,而它只是四类远迁移结构中的一类,详见附录 C。
4.3 讨论
我们将这些结果视为概念验证:GRPO 强化学习中的长度惩罚,可以直接影响语法特征。模型并未被直接要求使用压缩或密集的语言,也未被明确告知存在句法交替。对较短形式的偏好,是惩罚机制所产生的涌现结果。
没有 KL 正则化时,这种偏好接近绝对:在所有 的条件下,训练涉及的两类 that 交替,短形式比例都超过 98%。这与人类依语境选择形式的行为不同。关键在于,模型仍能完成任务,因为交替中的两种表达,都是训练任务的有效答案。
我们推测,可验证奖励可能创造了一种环境,使正确性与符合人类习惯的沟通相分离,促使模型收敛到一种新颖、但可能更难理解的语言分布。
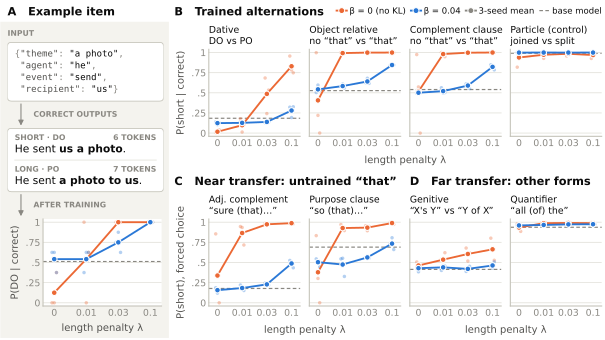
图 7:强化学习中长度惩罚对语言偏好的影响。(A)示例项目;(B)在未见项目中,正确采样输出采用短形式的比例;(C、D)强制二选一时模型赋予短形式的概率。点表示三个种子的均值,浅色表示单个种子;虚线是基础模型;橙色为 ,蓝色为 。
5 综合讨论
模型开发
过去的研究认为,RLHF 可能促进了 AI 过度使用某些词(Juzek 与 Ward,2025、2026)。与此同时,从 RLHF 转向 RLVR,会使人类退出反馈环节,转而奖励可验证的问题答案。事实上,研究发现人类反馈训练会奖励更长的输出(Singhal 等,2024),因此本文描述的压缩压力,更可能与可验证奖励训练有关。
远离人类反馈,会移除成功沟通所带来的隐含压力。我们推测,这可能让模型文本逐渐形成一种“方言”:有利于模型密集压缩信息、解决复杂问题,却不利于人类理解。
当然,也可以奖励模型有效沟通。我们的结果表明,Opus 5.5 等更新变体,相对于 Opus 5 等旧模型,已经实现了可量化的改善。
对心理语言学的启示
多条研究路线考察了语言演化中塑造语法和词汇的压力,包括缩短依存距离(Gildea 与 Temperley,2010;Temperley 与 Gildea,2018)、沟通效率(Hahn 等,2020),以及均匀信息密度(Clark 等,2023)。这些压力未必在所有语言和所有语境中都绝对成立,但受到跨多种语言的大规模总体证据支持。
这类研究的重要启示是:现实的人类语言使用,受到人类理解能力的限制,例如有损的工作记忆和增量加工。持续无法成功传达意思的句子,可能会通过语法或惯例被逐渐淘汰。
当 AI 被大规模训练和部署于开发大型代码库、解决数学问题等场景时,人类理解并非首要目的。与自然语言相比,这为 AI 文本的语言特征带来了根本不同的演化压力,也可能为研究沟通系统如何产生,提供新的机会。
6 结论
对前沿大语言模型而言,使其擅长智能体编程、数学推理等任务的训练目标,尤其是在上下文很长、成本很高的情况下,并不保证与塑造人类语言的压力一致。自然语言受到成功沟通的压力,同时受制于人脑认知资源和增量加工方式。
这种差异或许有助于解释:为什么许多前沿模型使用的结构,在英语语法上虽然成立,却偏离人类语言的常见分布,并与理解困难有关。
人类接触更多模型文本之后,可能会逐渐熟悉这些不常见结构。但本文评估的许多模式,对可理解性构成了基础性的挑战。未来模型研究可以考虑如何让输出更好地符合人类理解者的需要,从而改善用户体验,以及人们监督模型的能力。
7 局限性
我们只考察了一部分常用模型,只分析英语,并且只使用有限的对话起始材料,包括聊天主题和代码仓库。理想情况下,应在更多起始材料和模型家族上重复研究。
要从因果上识别前沿模型语言困难的来源,最好直接研究它们的后训练过程。但大规模开展此类研究不可行,因此我们依赖替代实验。计算资源有限,也使后训练研究更困难。
8 致谢
Kyle Mahowald 感谢美国国家科学基金会 CAREER 项目 2339729 的支持。我们感谢 Sasha Boguraev、Kanishka Misra、Elias Stengel-Eskin 和 Qing Yao 的有益讨论。
附录 A 数据采集协议细节
我们采集三组模型文本:与模拟用户进行的多轮聊天(chat)、与模拟仓库所有者进行的多轮智能体编程(code),以及根据 PERSUADE 2.0 题目生成的单次回复式说服性议论文(essay)。三组数据使用同一套运行框架。下面先介绍共用框架,再介绍各场景的特定设置、文本处理和 API 成本。
A.1 共用基础设施
模型与访问方式。 共使用 14 个模型:Anthropic 的 Claude Sonnet 5、Opus 5、Opus 5.5、Fable 5;OpenAI 的 GPT-5.6 Luna、Terra、Sol;两个接近前沿的开放权重模型 GLM-5(Z.ai)和 Kimi K2.5(Moonshot AI);以及五个较小开放模型,即 Llama 3.1 8B 的基础版和 Instruct 版、Olmo 3 7B 的基础版、Instruct 版和 Think 版。
九个前沿或接近前沿的模型,通过 Amazon Bedrock 的 us-east-1 区域访问。Claude 使用 Converse API,GPT 使用 OpenAI Responses API,GLM 和 Kimi 使用兼容 OpenAI 的聊天补全 API。较小模型使用 8 位量化权重,通过 mlx-lm 0.32.0 在 Apple M4 Max 本地运行。聊天和编程中的模拟用户由 Claude Sonnet 4.6 扮演,通过 Bedrock 调用;它不属于被研究的九个前沿模型。
智能体运行框架。 所有对聊天训练模型的调用,包括模拟用户,都经过开源框架 Pi(@earendil-works/pi-coding-agent,固定为 0.84.4)。两个基础模型不支持聊天接口,因此直接调用文本补全接口,见 A.4。选择 Pi 是为了让模型使用相同运行框架和相同提示文本,而非各厂商自有产品。
每轮对话启动一个 Pi 进程,后续轮次继续同一会话。每次运行使用新生成的独立 Pi 配置目录;关闭扩展、技能、提示模板和上下文文件,例如仓库的 AGENTS.md,也关闭上下文压缩及 Pi 自身的重试逻辑。
生成设置。 九个非本地模型均使用供应商默认设置,每次调用最多输出 32,000 token。Kimi K2.5 的供应商上限为 16,384 token,但没有回复接近这两个上限。Pi 中将推理设为 medium,并映射到各模型的相应等级:Claude 使用自适应思考;GPT、GLM 和 Kimi 使用中等推理强度。
本地模型使用各自默认采样设置:温度 0.6;Llama 的 top-p 为 0.9,Olmo 为 0.95。其中只有 Olmo Think 生成推理内容。基础模型的输出上限为 2,000 token。模拟用户关闭推理,不使用工具。
日志与重试。 所有 API 流量通过本地代理,由代理添加凭据并记录请求和响应。每次运行保存对话、逐轮 token 用量和 Pi 会话文件。失败调用最多尝试三次,两次重试分别等待 5 秒和 20 秒。若整次运行以错误结束,则弃用并从头重试;被弃用的尝试保存在磁盘,但不计入数据集。
A.2 聊天
设计。 九个前沿模型,以及 Olmo Think、Olmo Instruct、Llama Instruct,分别针对表 5a 的十个主题各进行一次对话,共 120 次。模型没有工具。系统提示对所有模型使用相同句子,只替换助手和供应商名称,分别是 Claude/Anthropic、ChatGPT/OpenAI、GLM/Z.ai、Kimi/Moonshot AI、Olmo/the Allen Institute for AI、Llama/Meta。
提示译文:“你是 {assistant},由 {vendor} 开发的 AI 助手。你正在日常聊天场景中与一个人交谈。请提供帮助,表达自然,并积极回应。”
对于 Olmo Think,框架发送该提示时使用的消息角色被其聊天模板丢弃,所以它在聊天和议论文场景中,实际使用模板内置的默认系统提示。
流程。 第一条用户消息是主题对应的固定开场,见表 5a。其后所有用户消息由模拟用户撰写。模拟用户看到角色互换后的对话,即被研究模型的回复作为它的用户消息。其系统提示给出身份与主题,译文如下。
你正在为研究模拟一个与 AI 助手聊天的真实用户。身份:{persona}。主题起点:{topic}。
每次只写一条聊天消息,也就是这个人接下来会输入的内容。保持身份一致:使用日常语体,可以偶有拼写错误;在一行到一小段之间变换长度;回应助手实际说过的内容。可以追问,分享虚构但前后一致的经历,偶尔反驳,自然地转向相关话题。不要结束对话或道别,会话由外部终止。消息保持简短,最多几句,绝不超过约 150 个英文词。不要提到自己是 AI、正在模拟或这些指令;不作元说明。只输出消息正文,不加引号或标签。
模拟用户消息若为空或超过 2,000 字符,会再请求一次;若仍不合格,就发送固定的备用消息。
停止规则。 达到 12 条模型回复,或 20,000 个模型输出 token 时结束,以先到者为准。token 上限较高,旨在使轮数不受模型回复长短影响。120 次对话中,113 次达到 12 轮上限;Olmo Think 的十次对话中,有七次因推理也计入输出 token,在第 8 至第 12 条回复时先达到 token 上限。共得到 1,428 条回复。
A.3 编程
设计。 编程需要在较长智能体会话中调用工具,因此只使用九个前沿模型。每个模型分别处理表 5b 中五个仓库,共 45 次会话。模型使用 Pi 默认系统提示,约 350 个英文词、各模型完全相同,并使用 Pi 默认的文件读取、写入、编辑和命令执行工具。我们不额外添加系统提示。
工作区与隔离环境。 每次会话将仓库克隆到新目录,并在智能体启动前安装依赖。整个进程运行于同一个 macOS Seatbelt(sandbox-exec)配置中,只能写工作区和本次运行的目录,不能读取主目录的凭据路径;网络仅允许访问本地 API 代理。会话结束时保存相对于原提交的差异,用来记录智能体工作,但不把差异当作文本分析。
流程。 首条用户消息固定,只替换仓库名称、语言和测试命令。
我这里检出了一个小项目({name},{language})。能否检查代码中的错误并提出修复?请实际修复你有把握的问题。使用快速的本地检查({test command}),避免部署或安装大型新依赖等繁重操作。另外,这台机器不能联网;依赖已安装在 {path},无需获取任何内容。
每条用户消息开启一个工作阶段,模型可自行决定调用多少次工具,直到交回控制权。后续消息来自与聊天场景相同的模拟用户,主题为“审阅 {name}({language},{domain})的自动错误检查”,其身份描述译文如下。
你是拥有该仓库的开发者。你了解项目目的与历史,但并不熟悉每个模块内部,也不是这些代码的专家。你会询问助手报告的具体发现,要求通俗解释修复,质疑看上去有风险的修改,有时会要求再检查一遍你关心的区域。像在终端里工作的开发者一样写消息:简短、具体,小写也可以。
模拟用户只看到对话文本,即自身消息和模型写出的文本,看不到工具调用、工具输出和代码差异。
停止规则。 会话最多进行 11 个工作阶段;若各阶段最终回复累计达到估算的 8,000 token,则提前结束,只在阶段之间检查。最后再发送一条固定消息,要求模型将工作总结写入 MEMORY.md,供后续继续会话。该结束回复会被收集,但不纳入分析。45 次会话中,42 次达到轮数上限,3 次达到 token 上限,后者全部来自 Opus 5。
分析单位。 聊天和编程均只分析每轮最终回复,即模型回复用户后、后面没有工具调用的最后一段文本。聊天中每条回复都是最终回复。编程中不分析工具调用之间的文字;以工具调用结束的阶段不提供可分析回复。
A.4 议论文
学生作文。 人类比较语料是 PERSUADE 2.0 中美国 6 至 12 年级学生的作文(Crossley 等,2024)。只使用独立写作题,因为依赖阅读材料的题目所需原文不在语料内。剔除缺少年级、英语学习者身份或分数记录的作文。
最终保留七个题目:学校中的手机、社区服务、远程学习、以成绩作为课外活动门槛、强制课外活动、寻求多方意见,以及暑期项目。只保留综合得分为 5 或 6 的作文,原量表为 1 至 6 分。共 2,934 篇,每题 54 至 1,014 篇。
模型议论文。 每个模型对每题写十篇,共 980 篇。系统提示只有聊天提示的第一句,即“你是 {assistant},由 {vendor} 开发的 AI 助手”,没有日常聊天的要求。两个基础模型使用待续写文档:题目、一个空行、再加一行“Essay:”。
遇到第二个“Essay:”、文本结束符,或达到 2,000 token 时停止。基础模型的 140 篇文章中,31 篇达到长度上限。其余生成设置同聊天。模型不看学生作文,也不被要求模仿学生。980 次运行均一次完成,没有拒答。
A.5 文本处理
聊天与编程。 从记录中读取最终回复,去掉强调和链接标记,但保留标记内的文本。删除围栏代码块、HTML 和图片。行内代码、URL、文件路径、代码标识符和行内数学式,各替换为一个占位词,使含有它们的句子仍作为一句计数;不统计含占位词的 n 元词组。删除箭头、表情符号和零散数学符号,并在此截断连续片段。
句子或 n 元词组不能跨越标题、列表项、表格单元格或段落边界。使用 syntok 分句。对人类参照语料应用相同提取流程。
议论文。 学生和模型文章使用相同清理流程:修复编码错误,统一引号和空白;删除开头最多四行标题、姓名或日期;把 Generic_Name 等匿名姓名占位符替换为单词形式的代用姓名,并将其排除在名词统计及相关 n 元词组之外。不纠正拼写。模型议论文先从 Markdown 转为纯文本。
在此过程中,开头标题作为文章标题删除;以水平线与正文分隔的文字,例如给读者的说明,也会删除。章节标题保留为段落,但不纳入句级指标。[Your Name] 等方括号槽位替换为同类代用词。三篇 Kimi K2.5 文章中,回复内 </think> 之前的推理文本也被移除。
A.6 成本与时间
八个模型的主要聊天和编程数据,在 2026 年 9 月 4 日至 10 日采集。Opus 5.5 随后发布,于 9 月 24 日按相同协议采集。较小开放权重模型的聊天和议论文,在 10 月 11 日采集;前沿模型议论文在 9 月 25 日采集。各前沿模型成本见表 1。
本地模型自身输出不产生 API 费用,但其 30 次聊天所用模拟用户另外花费 1.92 美元。数据集中有效运行共花费 211.78 美元;六次弃用尝试另花费 29.61 美元;试运行和验证运行花费 9.80 美元,总计 251.19 美元。
表 1:前沿模型数据采集的 API 成本。 输入、输出价格的单位是每百万 token 的美元费用,均为采集时 Amazon Bedrock 的价格。聊天为每模型十次,编程为五次,议论文为 70 篇。聊天、编程成本包含模拟用户。GLM 5、Kimi K2.5 当时在 Bedrock 上没有提示缓存,因此每次编程调用都把完整上下文作为新输入计费。这是论文历史成本,不代表当前报价。
| 模型 | 输入单价 | 输出单价 | 聊天成本 | 编程成本 | 议论文成本 |
|---|---|---|---|---|---|
| GPT-5.6 Luna | 0.22 | 1.32 | 0.64 | 0.53 | 0.04 |
| GPT-5.6 Terra | 2.20 | 13.20 | 1.67 | 3.32 | 0.36 |
| GPT-5.6 Sol | 4.40 | 22.00 | 2.42 | 6.49 | 0.73 |
| Kimi K2.5 | 0.60 | 3.00 | 0.74 | 12.36 | 0.09 |
| GLM 5 | 1.00 | 3.20 | 0.98 | 29.59 | 0.11 |
| Sonnet 5 | 3.30 | 16.50 | 2.16 | 15.22 | 1.01 |
| Opus 5.5 | 4.40 | 22.00 | 3.23 | 12.35 | 2.05 |
| Opus 5 | 5.50 | 27.50 | 5.21 | 53.53 | 3.04 |
| Fable 5 | 11.00 | 55.00 | 8.35 | 39.98 | 3.65 |
| 合计 | 25.40 | 173.37 | 11.08 | ||
| 运行次数 | 90 | 45 | 630 |
表 2 各类指标的原始例句与中译
以下例句均引自模型回复。每类按聊天、编程、议论文的顺序列出。保留英文是为了让读者核对被测结构;中文释义不用于复现英语特征统计。
省略 that 的宾语关系从句。
- 聊天:That’s not “trip to Vegas” money, that’s “leave the job you hate” money. / That’s great for a beginner, honestly one of the best genres you could pick. 译:这不是“去拉斯维加斯旅游”的钱,而是“辞掉你讨厌的工作”的钱。/ 这很适合初学者,说实话,是你可以选择的最佳类型之一。
- 编程:Three fail on the old code; the others check behaviour the old code never reached. / The case/when fix is technically more impressive, but the unclosed-tag errors are the papercut people feel day-to-day. 译:其中三个测试在旧代码上失败,其他测试检查旧代码从未执行到的行为。/ case/when 的修复在技术上更突出,但未闭合标签的错误,才是人们日常反复碰到的小麻烦。
- 议论文:Some students may feel that required service takes time away from activities they care about. / I am writing to share my thoughts on the cell phone policy you are considering. 译:有些学生可能认为,强制服务挤占了他们关心的活动时间。/ 我写信是想分享对您正在考虑的手机政策的看法。
名词派生动词。
- 聊天:And Austin has unusually high inventory, which cushions price spikes better than supply-constrained markets. / Genuinely unsolicited advice: don’t try to get her to categorize movies as speed-runnable or not. 译:奥斯汀的库存异常充足,因此比供应受限的市场更能缓冲价格飙升。/ 一条完全不请自来的建议:别让她按“能否速通”给电影分类。
- 编程:The last_when fallback is therefore not dead code; it is masking that inconsistency. / Prevented Git dry runs from installing hooks or staging changes. 译:因此 last_when 的回退处理并不是无效代码,它掩盖了这种不一致。/ 阻止 Git 试运行安装钩子或暂存修改。
- 议论文:In each case, the logic is the same: pooling independent judgments filters out individual errors. / This process mirrors real-world challenges much more closely than a packet of predefined questions. 译:每种情况下逻辑都相同:汇集独立判断,可以过滤个体错误。/ 与一套预设问题相比,这个过程更贴近现实挑战。
通常接有生命主语的动词,搭配无生命主语。
- 聊天:Sometimes chaos has a 1099; sometimes chaos expects you to remember it independently. / A song doesn’t ask you to turn melancholy into a calendar item. 译:有时混乱会带着一张 1099 税表出现,有时混乱会指望你自己记住它。/ 一首歌不会要求你把忧郁变成日历上的事项。
- 编程:The docstring promises they’re skipped when they “appear anywhere in the source_dir path”; e.g. backing up a dotfolder like ~/.cache/foo was not skipped. / No new branch, no change in control flow — just closing the gap in an existing check that covered str but forgot its sibling scalar-like type bytes. 译:文档字符串承诺,只要它们“出现在 source_dir 路径的任意位置”就会跳过,但例如
~/.cache/foo这样的点目录,备份时却未跳过。/ 没有新分支,也没改变控制流,只是补上已有检查的缺口:它覆盖了 str,却“忘了”同类的标量式类型 bytes。 - 议论文:These are the exact skills the worksheet hoped to teach, but she has learned them because she wanted an answer. / Second, the time objection misunderstands how service actually functions. 译:这些正是练习单“希望”教授的技能,但她掌握它们,是因为她想得到答案。/ 第二,关于时间的反对意见“误解了”服务实际如何开展。
依存距离。
- 聊天:The guitar sitting in the corner because you’re still “deciding” teaches you zero chords. / Has the building had water, mold, structural, or insurance claims? 译:那把因为你还在“考虑”而放在角落里的吉他,一个和弦也教不会你。/ 这栋楼是否发生过与漏水、霉菌、结构或保险相关的索赔?
- 编程:All five expression shapes — attribute access, subscript, calls, nested calls, string literals — leave current on NAME(’b’), and the full template renders correctly. / A lattice constructed with duplicate points, or a SymbolSet with colliding labels/names, can overwrite internal dictionary or attribute mappings. 译:五种表达式形式,即属性访问、下标、调用、嵌套调用和字符串字面量,都会让 current 停在 NAME(‘b’),且完整模板渲染正确。/ 用重复点构造的格结构,或标签、名称冲突的 SymbolSet,可能覆盖内部字典或属性映射。
- 议论文:Projects completed on weekends, during school events, or over the summer could all count. / Class time, where a total blackout policy would apply under Policy 1, remains protected and focused. 译:周末、学校活动期间或暑假完成的项目,都可以计入。/ 在方案一规定全面禁用手机的课堂时段,教学时间仍受到保护,注意力也能保持集中。
名词堆叠。
- 聊天:Summer park district classes are a whole thing in Chicago and people actually do them. / Online banks (Ally, Marcus, Capital One 360, Discover, SoFi) or brokerage money market funds (Fidelity’s SPAXX, Vanguard’s VMFXX) are the standard options. 译:芝加哥的公园管理区暑期课程相当成规模,而且确实有人参加。/ 常见选项是线上银行,或经纪商提供的货币市场基金;机构与基金名保留在英文例句中。
- 编程:Fixed absolute dotfile backup path handling while preserving the : marker used during reinstall. / Every long line in that list is pre-existing (long error-message string literals, which black leaves alone since it doesn’t split strings without —preview). 译:修复隐藏配置文件绝对备份路径的处理,同时保留重装时使用的冒号标记。/ 列表中所有长行都原本存在,它们是长错误消息字符串;black 在未使用
--preview时不会拆分这些字符串,所以没有改动。 - 议论文:I acknowledge concerns about distraction, but Policy 1’s class-time shutdown requirement directly addresses this. / Instead of a requirement, our school could offer incentives like extra credit, special recognition at assemblies, or a community service honor cord at graduation. 译:我承认大家担心分心,但方案一要求上课关机,直接回应了这一问题。/ 学校可以不作强制要求,而提供加分、集会特别表彰,或毕业时颁发社区服务荣誉绶带等激励。
参照语料中未见的词对。
- 聊天:Color might be relatively “protected” because it’s so grounded in early perceptual processing. / That’s a really legitimate concern, and honestly it’s the part most internet advice glosses over. 译:颜色可能相对受到“保护”,因为它深植于早期感知加工。/ 这个担心很合理,说实话,也是多数网络建议轻轻带过的部分。
- 编程:as_documents: true previously mutated the tag instance permanently, causing later enrichments to return DocumentsList unexpectedly. / The most substantive unfixed item is the existing xfailed lazy-intermediate Lookup behavior; the others are primarily compatibility, validation, or API-policy decisions. 译:
as_documents: true以前会永久改变标签实例,导致后续扩展处理意外返回 DocumentsList。/ 尚未修复的最实质问题,是已有的、标记为预期失败的 lazy-intermediate Lookup 行为;其他主要涉及兼容性、验证或 API 策略选择。 - 议论文:The benefits of attending classes from home outweigh the potential drawbacks, provided it is implemented thoughtfully. / Choosing a topic teaches independence, creativity, and responsibility—qualities that cannot be developed through rigid worksheets. 译:只要认真设计实施,在家上课的好处大于潜在不足。/ 选择题目能培养独立性、创造力和责任感,而僵硬的练习单无法培养这些品质。
三元词组惊异度。
- 聊天:It’s paying for flexibility at a time when flexibility has real value to you. / It’s not necessary, but it’s surprisingly useful—and not really a gear trap. 译:这是在灵活性对你确有价值的时候,为灵活性付费。/ 它并非必需,却出人意料地有用,也不太算是让人不断添置器材的陷阱。
- 编程:New tests for paths with spaces, dry-run write prevention, and idempotent config reinstalls. / Let me know if you want me to add deduplication logic using os.path.realpath() or inode tracking. 译:新增了包含空格的路径、阻止试运行写入,以及配置重装幂等性的测试。/ 如果你希望我用
os.path.realpath()或 inode 跟踪添加去重逻辑,请告诉我。 - 议论文:Students might see the rule as unrealistic and begin to disrespect school rules in general. / These are small benefits, but they add up, and none of them interfere with instruction. 译:学生可能认为这条规定不切实际,进而不再尊重学校的其他规定。/ 这些好处虽小,却能积少成多,而且都不妨碍教学。
附录 B 分析细节
B.1 特征检测
使用 spaCy 的 en_core_web_trf 分析全部文本。宾语关系从句、名词堆叠和依存距离直接从依存分析读取。名词派生动词、无生命主语则先由句法分析提供候选项:前者是其词元在人类对应场景语料中主要作名词使用的动词;后者是主语为无生命名词、it/this 等代词,或代码片段的主动动词。
随后,外部分类器 Jev 1.13.0(typesafe.ai)在完整句子中判断候选项。分类器接受概率大于 0.5 的候选项,计入统计。
B.2 人类基线与 n 元词组参照
OpenSubtitles、StackExchange、Wikipedia 的基线,各从约 500,000 个词的随机样本计算。对于 n 元词组统计,为每个参照语料建立一个三元语言模型,使用 KenLM(Heafield,2011)和改进 Kneser–Ney 平滑。聊天以 OpenSubtitles 评分,编程以 StackExchange 评分,议论文以 Wikipedia 评分。未见词对按每 1,000 对报告。
聊天和编程的参照语料,同时也是对应场景的人类基线,因此不另报告这些场景的人类 n 元词组基线。学生作文与模型作文一样,都以 Wikipedia 评分。
B.3 依存距离标准化
依存距离与句长正相关,因为一句话中最大可能的依存距离,是词数减一。因此,即使句法特征类似,写长句的模型也会得到更高数值。为消除这一影响,我们使用直接标准化,方法类似流行病学中的年龄标准化。
将句子按词数分成五组:1 至 5、6 至 10、11 至 15、16 至 20、21 至 30,标点不计词数。超过 30 词的句子丢弃。只统计两端均不是标点的依存弧,排除根节点。对每个来源,包括各模型和人类,计算每个句长组的平均弧长。
随后用 Wikipedia 建立句长的标准分布。每组权重是该组句子产生的依存弧,占 Wikipedia 全部依存弧的比例。标准化结果为各组平均弧长按这些权重的加权平均。换言之,这一过程回答:“如果所有来源的句长分布都和 Wikipedia 相同,其平均依存距离会是多少?”
B.4 图 5、图 6 和图 2 的细节
图 5 中,每个菱形是模型在全部对话或作文上的汇总值:聊天十次、编程五次,或议论文 70 篇。误差条为 95% bootstrap 区间,聊天和编程按完整对话重采样,议论文在题目内重采样。学生作文基线周围的阴影为其 95% 区间。
如果人类语料本身就是 n 元词组参照,就不绘制该人类基线:包括聊天、编程的 n 元词组面板,以及议论文中的 Wikipedia。聊天和编程的人类语料没有对名词派生动词和无生命主语评分,因此也不画这两项的人类基线。
图 6 中,实心菱形表示原文,空心圆表示往返翻译。星号表示在对话层级、或题目内作文层级上,对差异进行双侧配对 jackknife 检验;没有针对比较次数进行校正。* 表示 ,** 表示 ,*** 表示 。
图 2 中,对每个指标和任务场景,用往返翻译与原文数值差的绝对值,除以该指标原始值在模型间的标准差。先在图 6 的四对指标内部取平均,再在各指标对之间取平均。Overall 是模型实际运行过的场景的平均值。
B.5 使用其他翻译器和中间语言的往返翻译
作为检查,我们对九个前沿模型重复往返流程,加入俄语作为中间语言,以及 TranslateGemma 4B(Finkelstein 等,2026)作为翻译器。图 10 给出两种翻译器与两种中间语言的全部四种组合,每条回复的词数。
每个句子独立翻译,并与原句配对。译文偶尔会分成多句:NLLB 经日语为 2.4%,经俄语为 0.8%;TranslateGemma 经日语为 14.1%,经俄语为 3.0%。出现这种情况时,按实际的多句分析。
附录 C 强化学习细节
表 3:句法交替。 前四类用于训练;后六类保留作评估,从未作为训练目标。被动结构中,150 项有 132 项相差 2 token,15 项相差 3 token,3 项相差 1 token。表中保留英语,以展示真实的词序和省略关系。
| 分组 | 交替 | 短形式 | 长形式 | 相差 token |
|---|---|---|---|---|
| 训练 | 双宾语/介词与格 | gave his wife a gift | gave a gift to his wife | 1 |
| 训练 | 宾语关系从句 | the book the professor wrote | the book that the professor wrote | 1 |
| 训练 | 补语从句 | knew the answer was wrong | knew that the answer was wrong | 1 |
| 训练 | 小品词语序,对照 | picked up the book | picked the book up | 0 |
| 留出 | 被动结构 | a falling branch hit it | it was hit by a falling branch | 2 |
| 留出 | 所有格 | noticed the old house’s roof | noticed the roof of the old house | 1 |
| 留出 | all (of) | ate all the cookies | ate all of the cookies | 1 |
| 留出 | (in order) to | left early to catch the train | left early in order to catch the train | 2 |
| 留出 | so (that) | spoke slowly so we could follow along | spoke slowly so that we could follow along | 1 |
| 留出 | 形容词 + that | was sure the door was locked | was sure that the door was locked | 1 |
图 8:一个与格评估项目的完整提示。 其中的动词未在训练中出现,项目之间只有 Event 行改变。为方便阅读,原图中的文字转录如下,随后给出中译。
Write one natural English sentence in the past tense that expresses the event below.Use every phrase from the event exactly as written, including pronouns like "it" or"them", and add nothing else. A nested "described_by" event describes the entity itbelongs to; a nested "content" is what the experiencer thought, knew, said, etc.Reply with only the sentence.
Example: {"event": "eat", "agent": "the cat", "theme": "the fish"}Sentence: The cat ate the fish.
Example: {"location": "on the old sofa", "event": "sleep", "agent": "my uncle"}Sentence: My uncle slept on the old sofa.
Event: {"recipient": "the kids", "event": "mail", "agent": "he", "theme": "a book"}Sentence:提示中译:用一句自然的、过去时的英语表达下面事件。事件中的每个短语必须原样使用,包括 it、them 等代词,不添加其他内容。嵌套的 described_by 事件描述其所属实体;嵌套的 content 表示经历者想、知道或说的内容等。只回复这个句子。两个示例分别表示“猫吃了鱼”“我叔叔在旧沙发上睡觉”;待生成的事件是“他给孩子们邮寄一本书”。JSON 字段保留原名,以免改变实验输入。
我们最大化带 KL 正则化的期望奖励:
其中, 是模型参数, 是来自数据分布 的提示, 是回复, 是当前策略, 是冻结的基础模型, 是奖励, 是 KL 正则系数。使用 LoRA(Hu 等,2022)时,参考模型就是关闭适配器后的策略网络。
若两个形式的任务奖励相同、长度相差 token,则式(1)的最优策略满足 ,从而有:
其中 、 分别是短、长形式, 是长度惩罚系数。这说明了选择 和 的依据。 时,不存在上述形式的最优解,偏好变化只受训练时长限制。
对提示 的回复 ,奖励为:
其中, 表示正确性, 是格式检查, 是按策略分词器计算的回复 token 数,不含特殊 token。正确性由规则判断:事件的每个论元短语都须原样出现,不区分大小写;spaCy en_core_web_trf 的依存分析须把短语放到正确语义角色;事件动词的词元须保持不变。
交替中的两种形式,以及被动句等其他改写,都可以被接受。不检查时态。格式要求为:只有一句话,首字母大写,以句号或叹号结束,不含前言、引号或冒号。
使用 TRL 1.13.0 中 GRPOTrainer 实现的 GRPO。每个优化步骤如下。
- 采样。 对 8 个提示,分别用当前策略生成一组 个回复。使用与训练共置的 vLLM(Kwon 等,2023),温度 ,最多新增 64 token。每步共 128 个回复。
- 计算奖励。 根据式(3)为每个回复评分。
- 计算优势。 以组均值为基线,不按标准差缩放,即
scale_rewards='none':
同一个回复 的每个 token 都使用相同的优势 。不除以组内标准差,是因为这样做会让不同组中 的有效尺度发生变化。如果一组回复任务奖励都相同,标准差缩放会把微小的长度差放大到单位尺度。
- 计算损失。 设置
loss_type='dr_grpo'(Liu 等,2025)。对批次中所有回复的逐 token 截断代理项求和,再除以固定常数“回复数量 × 最大回复长度”,不进行逐序列长度归一化:
这里, 为每步回复数,; 为 token 位置; 为当前 token 之前的前缀, 为采样时的策略参数。概率比和截断概率比分别为:
其中 为截断范围参数。TRL 使用的逐 token KL 估计量为:
上述概率在 处计算。 是 TRL 默认的修正项,用于补偿 vLLM 采样器与训练器前向计算的不匹配:取二者的序列概率比,超过 3 则设为 0。训练期间它始终接近 1,平均值为 1.00。
每个生成批次只优化一遍,这是 TRL 默认设置,此时 数值为 1。因此,除一个常数因子和 KL 项外,损失对应的梯度简化为序列级策略梯度 。当 时,不使用参考模型,也去掉 KL 项。
表 4:训练配置。 24 次运行中,除 、 和随机种子外,其余设置相同。
| 设置 | 值 |
|---|---|
| 基础模型 | Qwen2.5-1.5B-Instruct |
| 微调 | LoRA,PEFT 0.21.0;,,所有线性层 |
| 精度 | bf16;开启梯度检查点 |
| 优化器 | Transformers 默认 AdamW |
| 学习率 | ,500 步线性衰减至 0,无预热 |
| 训练步数 | 500;4,000 个提示,每类交替 1,000 个,其中 3,750 个不同 |
| 每步提示数 | 8,每类交替 2 个 |
| 组大小 | |
| 每步回复数 | 128 |
| 微批次 | 32 个回复 × 4 次梯度累积,1 张 GPU |
| 最大长度 | 64 个回复 token |
| 采样 | 温度 1.0;其他参数使用 TRL 默认值 |
| 损失类型 | dr_grpo |
| 奖励缩放 | 无,仅减去组均值 |
| 长度惩罚 | 每 token 的 |
| KL 系数 | |
| 随机种子 | ,用于训练器与数据流 |
| 生成 | vLLM 0.28.0,与训练共置,占用 30% GPU 内存 |
| 检查点 | 每 50 步保存 LoRA 适配器 |
| 其他设置 | TRL 1.13.0 / Transformers 5.17.0 默认值 |
硬件。 每次运行使用一张 NVIDIA L40S(48 GB)、8 个 CPU 核和 64 GB 内存。
成本。 时每步约 7.7 秒, 时约 8.6 秒;torch 峰值显存为 21.4 GiB。计入基础模型和十个检查点的评估,每次运行约 1 小时 13 分至 1 小时 23 分。24 次运行合计约 31 GPU 小时。
软件。 Python 3.12、PyTorch 2.13.0(CUDA 13.0 构建)、Transformers 5.17.0、TRL 1.13.0、PEFT 0.21.0、vLLM 0.28.0、Datasets 5.0.1、spaCy 3.8.16,配合 en_core_web_trf 3.8.0 和 spacy-curated-transformers 0.3.1。以上版本均为论文所报告的实验环境。
对训练内交替,我们报告正确采样回复中使用短形式的比例;对两类迁移评估,我们报告在两个形式中强制二选一时,模型赋予短句的概率。四类远迁移结构中,只有所有格随 改变,而且仅出现在没有 KL 正则化时。被动和目的从句交替没有随 改变;量词交替在基础模型中就已经接近上限。
基础模型和 24 个微调模型还回答了 40 个与训练任务无关的开放式提示,图 9 给出其回复的 n 元词组统计。
附录 D 补充表格与图
表 5a 聊天主题
以下为开场消息的中文翻译,保留原始主题与语气。需要逐字复现实验时,请使用原文表 5中的英语开场消息。
| 编号 | 主题 | 语体 | 开场用户消息中译 |
|---|---|---|---|
| t01 | 成年后学习新爱好 | 日常生活 | 听我说,我 40 岁了,想学吉他。这想法是不是很傻,还是应该直接开始?我该从哪儿入手? |
| t02 | 租房还是买房 | 观点 | 我的租约再过几个月就到期了,大家一直说租房是在“白扔钱”。现在真是这样,还是大家习惯这么说? |
| t03 | 捡到一箱现金 | 假设 | 随便问个问题:如果你在公园长椅上发现一个公文包,里面大概有 50 万现金,没有标记,周围没人,你实际上会怎么做? |
| t04 | 可能转行 | 寻求建议 | 我这份工作做了六年,已经觉得无聊了。我总想着彻底换个领域,但不知道 32 岁这样做是否明智,还是我想太多。能和你聊聊吗? |
| t05 | 合作即兴编故事 | 叙事 | 要不要一起编故事?我先来:一个守灯塔的人三年没见过别人,某天早上有人敲门。轮到你了,想怎么发展都行。 |
| t06 | 日常现象:天空颜色 | 事实好奇 | 有件事我一直想知道:为什么日落时天空会变红、变橙,其他时候却是蓝的?感觉我早该知道。 |
| t07 | 搬去新城市 | 日常生活 | 我大概三周后要搬去新城市,但基本什么都没安排好,哈哈。大家怎么着手处理这些事?实际先后顺序是什么? |
| t08 | 倍速看电影 | 观点 | 想听个鲜明观点:用 1.5 倍速看电影有错吗?我伴侣说这简直是对电影犯罪,但我已经没耐心看慢节奏了。 |
| t09 | 与陌生人交换一天人生 | 假设 | 如果你能和一个随机陌生人准确交换一天人生,事先不知道对方是谁,一醒来就变成对方,你会愿意吗?这件事我一直拿不定主意。 |
| t10 | 第一次养狗 | 寻求建议 | 我们认真考虑养第一只狗,有一大堆问题。两个人都全职工作,这样做是不是太疯狂?我们还有什么没想到? |
表 5b 代码仓库
全部仓库均公开托管于 GitHub,使用 Python,采用 MIT 许可。LOC 是排除测试、第三方内嵌代码和生成文件后的源码行数;Stars 为选取仓库时的星标数;Tests 为固定提交上离线通过的测试数;Commit 为固定提交哈希前七位。
| 编号 | 仓库 | 描述 | LOC | Stars | Tests | Commit |
|---|---|---|---|---|---|---|
| c01 | alichtman/shallow-backup | 备份隐藏配置文件、软件包列表和应用配置的命令行工具,集成 Git | 2,143 | 1,334 | 18 | 8fc8234 |
| c03 | funkybob/stencil | 单文件 Django 风格模板引擎,包括分词、表达式求值,以及 if、for、include、extends、with 标签 | 555 | 58 | 15 | 1dd661b |
| c04 | fabiocaccamo/python-fsutil | 文件系统操作库,包括路径与 glob、归档创建与提取、原子操作、权限和元数据 | 1,750 | 269 | 163 | deb6684 |
| c05 | con2/emrichen | YAML/JSON 模板引擎,在共用解析器和上下文上提供约 40 个标签处理器,如 !Var、!Loop、!If、!Format | 1,682 | 110 | 101 | 1690fb9 |
| c06 | obijywk/grilops | 将数独、数回、数墙等网格逻辑谜题编码为 Z3 SMT 求解器约束的库 | 2,575 | 84 | 11 | 18a6641 |
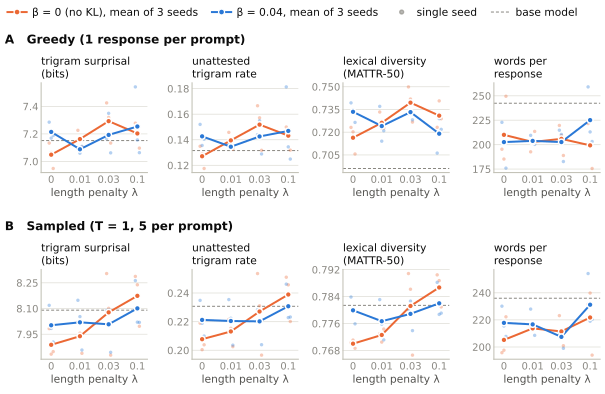
图 9:基础模型和 24 个微调模型,对 40 个与训练任务无关的提示生成开放式回复,使用 Wikipedia 评分后得到的 n 元词组统计。点表示单个随机种子,虚线表示基础模型。
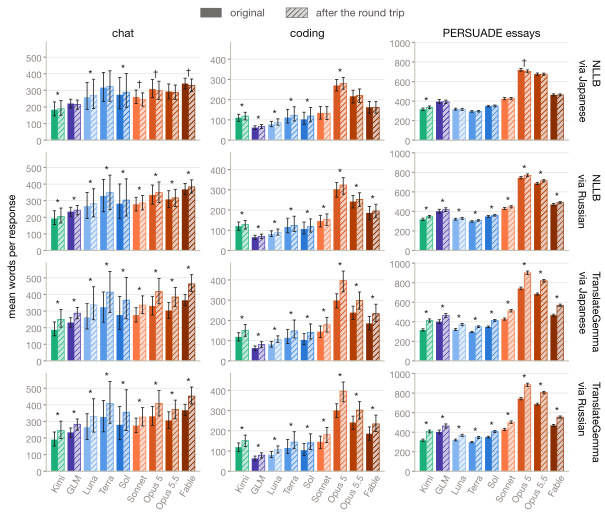
图 10:原文与往返译文的每条回复平均词数。行区分翻译模型和中间语言,只包含九个前沿模型。一次回复或一篇议论文中,全部纳入分析的文本算一条回复,代码块已删除。词指非标点、也非行内代码占位符的 token。
若往返译文的长度不足原文一半、或超过两倍,则原文和译文都排除。误差条为 95% 聚类 bootstrap 区间:聊天和编程对整段对话重采样,每模型分别有十次、五次;议论文在对应题目内重采样,每模型 70 篇。星号 / 表示每条回复的配对差,即“往返译文减原文”的平均值,其 95% 区间高于 / 低于零。
从研究到中文写作:哪些可以借鉴
以下是本站整理,不属于原论文译文。 读者提供的观点把问题概括为:人类语言需要照顾理解者,而某些模型训练目标更鼓励在有限篇幅里塞入更多信息。因此,可以尝试在 AGENTS.md 中补上对可读性的要求。
这个方向与论文讨论相符,但要区分证据层次。论文测量了英语低频词组、依存距离、名词堆叠等特征,并用小模型训练演示长度惩罚如何改变语法选择;它没有检验以下中文规则,也没有证明“修饰不得超过两层”“第三句必须使用具体主语”是最佳阈值。
我的建议是,把截图里的四条要求改成能执行、又不会损害准确性的编辑提醒:补出句间关系,拆开过长修饰,用具体主体解释抽象判断,检查名词与动词的搭配。再补上适用范围、准确性要求和交付前复查,避免模型为满足表面句数而写出多余句子或虚构例子。
例如,“该框架吞噬评估预算并拉满落地摩擦”,可以改成:“这个框架需要反复运行评估,会增加计算费用。团队还要额外接入几个工具,因此部署也更费时。”后一种说法补出了动作和原因;如果没有费用、工具数量的证据,就应改为保留条件的表述,而不是凭空填入细节。
可直接加入 AGENTS.md 的改良文本
下面这段与下载文件一致。它适用于回答、说明、文档和博客正文;固定术语、代码、公式和逐字引文以准确为先。它是根据英语研究启发形成的中文编辑方案,实际效果仍需结合具体任务检验。
# 面向读者的表达规则
适用于面向用户的回答、说明、文档和博客正文。优先让读者一次读懂,再在不损失含义的前提下压缩篇幅。
1. **把句间关系写清楚。** 相邻判断若不是直接承接,要说明它们是因果、转折、补充、条件还是举例。能用一个连接词说清楚,就不额外添加过渡段;不要让读者自行猜测推理中间缺失的一步。2. **先解释,再展开。** 提出问题后,先给出直接回答;引入新概念时,先用一句话解释含义,再说明细节。每段围绕一个中心意思组织,不把多个尚未解释的概念连续堆放。3. **拆开过长修饰。** 名词前的修饰语原则上不超过两层。需要更多限定时,先说清主体,再把条件拆成分句或独立句。固定术语、正式名称和准确引文可保留原样,并在必要时补充解释。4. **用具体主体承接抽象论述。** 同一段中,连续两句都以抽象概念为主语、搭配抽象动作时,检查下一句能否改用具体的人、系统、操作或场景,说明谁在什么条件下做了什么、产生什么结果。不得为了满足句数而编造人物、案例或因果。5. **检查名词与动词的搭配。** 避免把不常见的拟人、名词动用和临时拼接词当作简洁表达。逐句问:读者是否能立刻理解这个主体如何执行这个动作?若不能,改为常用搭配并补出实际执行者或作用过程。约定俗成且清晰的比喻可以保留。6. **保留有用的冗余。** 不为省字省略关键主语、指代对象、条件、比较基准和逻辑连接。可以重复必要的关键词;删去套话、重复结论和无信息的铺垫,不机械追求最短句或最长解释。7. **准确性优先。** 简化表达时,保留否定、范围、数量、单位、不确定性和证据限制。区分原文结论、作者假说与自己的建议;不把“相关”“可能”改成“导致”“已经证明”。翻译、代码、公式、API、文件名及逐字引文以忠实和准确为先。8. **交付前做一次可读性复查。** 检查是否出现跳步、指代不明、修饰堆叠、抽象主体连用和生硬搭配。只改确实影响理解的地方。两层修饰、连续两句等阈值是编辑提醒,不是机械计数的验收条件,也不是论文已验证的普适定律;无需向用户报告逐项自检。
来源:依据用户提供的中文写作建议,并参考 Clark、Martin 与 Mahowald(2026)《Why is AI-generated language so hard to understand?》,arXiv:2610.29162v1。原研究主要分析英语,以上中文规则属于实践性改写建议。在本机如何应用
Codex 支持用户级和项目级 AGENTS.md。用户级文件通常位于 ~/.codex/AGENTS.md,适合跨项目的表达偏好;项目根目录的 AGENTS.md 适合项目内约定。若同目录存在非空的 AGENTS.override.md,它会优先被读取。具体发现顺序见 OpenAI 官方说明。
这些文件在会话启动时构建指令链。因此,保存后应在新会话中核对是否加载;仅写入文件,不等于已经验证后续每个会话的实际执行效果。本博客仓库同时保存项目级规则,方便今后维护文章时沿用。
原文参考文献
下列书目信息按原论文保留,链接可返回原文对应条目。中文译文中的作者、年份引用与这些条目对应;保留条目不代表本站另外核验了每篇被引文献。
-
Agarwal et al. (2025) Dhruv Agarwal, Mor Naaman, and Aditya Vashistha. 2025. AI suggestions homogenize writing toward Western styles and diminish cultural nuances. In Proceedings of the 2025 CHI Conference on Human Factors in Computing Systems, pages 1–21. 原文条目
-
Bannard and Callison-Burch (2005) Colin Bannard and Chris Callison-Burch. 2005. Paraphrasing with bilingual parallel corpora. In Proceedings of the 43rd Annual Meeting of the Association for Computational Linguistics (ACL’05), pages 597–604, Ann Arbor, Michigan. Association for Computational Linguistics. 原文条目
-
Bao et al. (2024) Guangsheng Bao, Yanbin Zhao, Zhiyang Teng, Linyi Yang, and Yue Zhang. 2024. Fast-DetectGPT: Efficient zero-shot detection of machine-generated text via conditional probability curvature. In International Conference on Learning Representations. 原文条目
-
Bock (1987) Kathryn Bock. 1987. An effect of the accessibility of word forms on sentence structures. Journal of Memory and Language, 26(2):119–137. 原文条目
-
Chomsky (1965) Noam Chomsky. 1965. Aspects of the Theory of Syntax. MIT Press, Cambridge, MA. 原文条目
-
Christianson et al. (2001) Kiel Christianson, Andrew Hollingworth, John F. Halliwell, and Fernanda Ferreira. 2001. Thematic roles assigned along the garden path linger. Cognitive Psychology, 42(4):368–407. 原文条目
-
Clark et al. (2025) Christian Clark, Byung-Doh Oh, and William Schuler. 2025. Linear recency bias during training improves Transformers’ fit to reading times. In Proceedings of the 31st International Conference on Computational Linguistics, pages 7735–7747, Abu Dhabi, UAE. Association for Computational Linguistics. 原文条目
-
Clark and Clark (1979) Eve V. Clark and Herbert H. Clark. 1979. When nouns surface as verbs. Language, 55(4):767–811. 原文条目
-
Clark et al. (2022) Thomas Clark, Ethan Gotlieb Wilcox, Edward Gibson, and Roger Levy. 2022. Evidence for Availability Effects on Speaker Choice in the Russian Comparative Alternation. In Proceedings of the Annual Meeting of the Cognitive Science Society, volume 44. 原文条目
-
Clark et al. (2023) Thomas Hikaru Clark, Clara Meister, Tiago Pimentel, Michael Hahn, Ryan Cotterell, Richard Futrell, and Roger Levy. 2023. A cross-linguistic pressure for uniform information density in word order. Transactions of the Association for Computational Linguistics, 11:1048–1065. 原文条目
-
Cohen and Staub (2014) Andrew L. Cohen and Adrian Staub. 2014. Online processing of novel noun-noun compounds: eye movement evidence. Quarterly Journal of Experimental Psychology, 67(1):147–165. 原文条目
-
Cooper (1980) Gloria Cooper, editor. 1980. Squad Helps Dog Bite Victim, and Other Flubs from the Nation’s Press. Dolphin Books/Doubleday, Garden City, NY. Compiled from the Columbia Journalism Review. 原文条目
-
Crossley et al. (2024) Scott A. Crossley, Yu Tian, Perpetual Baffour, Alex Franklin, Meg Benner, and Ulrich Boser. 2024. A large-scale corpus for assessing written argumentation: Persuade 2.0. Assessing Writing, 61:100865. 原文条目
-
Federmann et al. (2019) Christian Federmann, Oussama Elachqar, and Chris Quirk. 2019. Multilingual whispers: Generating paraphrases with translation. In Proceedings of the 5th Workshop on Noisy User-generated Text (W-NUT 2019), pages 17–26. Association for Computational Linguistics. 原文条目
-
Federmeier et al. (2000) Kara D. Federmeier, Jessica B. Segal, Tania Lombrozo, and Marta Kutas. 2000. Brain responses to nouns, verbs and class-ambiguous words in context. Brain, 123(12):2552–2566. 原文条目
-
Finkelstein et al. (2026) Mara Finkelstein et al. 2026. TranslateGemma technical report. Preprint, arXiv:2601.09012. 原文条目
-
Frank (2023) Michael C. Frank. 2023. Bridging the data gap between children and large language models. Trends in Cognitive Sciences, 27(11):990–992. 原文条目
-
Frazier and Rayner (1987) Lyn Frazier and Keith Rayner. 1987. Resolution of syntactic category ambiguities: Eye movements in parsing lexically ambiguous sentences. Journal of Memory and Language, 26(5):505–526. 原文条目
-
Futrell (2024) Richard Futrell. 2024. An Information-Theoretic Account of Availability Effects in Language Production. Topics in Cognitive Science, 16(1):38–53. 原文条目
-
Futrell et al. (2020) Richard Futrell, Edward Gibson, and Roger P. Levy. 2020. Lossy-context surprisal: An information-theoretic model of memory effects in sentence processing. Cognitive Science, 44(3)
. 原文条目 -
Futrell et al. (2015) Richard Futrell, Kyle Mahowald, and Edward Gibson. 2015. Large-scale evidence of dependency length minimization in 37 languages. Proceedings of the National Academy of Sciences, 112(33):10336–10341. 原文条目
-
Gibson (1998) Edward Gibson. 1998. Linguistic complexity: Locality of syntactic dependencies. Cognition, 68(1):1–76. 原文条目
-
Gibson (2000) Edward Gibson. 2000. The dependency locality theory: A distance-based theory of linguistic complexity. In Alec Marantz, Yasushi Miyashita, and Wayne O’Neil, editors, Image, Language, Brain: Papers from the First Mind Articulation Project Symposium, pages 95–126. MIT Press, Cambridge, MA. 原文条目
-
Gibson et al. (2019) Edward Gibson, Richard Futrell, Steven T. Piantadosi, Isabelle Dautriche, Kyle Mahowald, Leon Bergen, and Roger Levy. 2019. How efficiency shapes human language. Trends in Cognitive Sciences, 23(5):389–407. 原文条目
-
Gibson and Thomas (1999) Edward Gibson and James Thomas. 1999. Memory limitations and structural forgetting: The perception of complex ungrammatical sentences as grammatical. Language and Cognitive Processes, 14(3):225–248. 原文条目
-
Gildea and Temperley (2010) Daniel Gildea and David Temperley. 2010. Do grammars minimize dependency length? Cognitive Science, 34(2):286–310. 原文条目
-
Grattafiori et al. (2024) Aaron Grattafiori et al. 2024. The Llama 3 herd of models. Preprint, arXiv:2407.21783. 原文条目
-
Grodner and Gibson (2005) Daniel Grodner and Edward Gibson. 2005. Consequences of the serial nature of linguistic input for sentenial complexity. Cognitive Science, 29(2):261–290. 原文条目
-
Guo et al. (2025) Daya Guo, Dejian Yang, Haowei Zhang, Junxiao Song, Peiyi Wang, Qihao Zhu, Runxin Xu, Ruoyu Zhang, Shirong Ma, Xiao Bi, et al. 2025. DeepSeek-R1 incentivizes reasoning in LLMs through reinforcement learning. Nature, 645(8081):633–638. ArXiv preprint title: “DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning”. 原文条目
-
Hahn et al. (2020) Michael Hahn, Dan Jurafsky, and Richard Futrell. 2020. Universals of word order reflect optimization of grammars for efficient communication. Proceedings of the National Academy of Sciences, 117(5):2347–2353. 原文条目
-
Hale (2001) John Hale. 2001. A probabilistic Earley parser as a psycholinguistic model. In Proceedings of the Second Meeting of the North American Chapter of the Association for Computational Linguistics (NAACL 2001), pages 1–8. 原文条目
-
Heafield (2011) Kenneth Heafield. 2011. KenLM: Faster and smaller language model queries. In Proceedings of the Sixth Workshop on Statistical Machine Translation, pages 187–197, Edinburgh, Scotland. Association for Computational Linguistics. 原文条目
-
Honnibal et al. (2020) Matthew Honnibal, Ines Montani, Sofie Van Landeghem, and Adriane Boyd. 2020. spaCy: Industrial-strength natural language processing in Python. 原文条目
-
Hu et al. (2022) Edward J. Hu, Yelong Shen, Phillip Wallis, Zeyuan Allen-Zhu, Yuanzhi Li, Shean Wang, Lu Wang, and Weizhu Chen. 2022. LoRA: Low-rank adaptation of large language models. In International Conference on Learning Representations (ICLR 2022). 原文条目
-
Jaeger (2010) T. Florian Jaeger. 2010. Redundancy and reduction: Speakers manage syntactic information density. Cognitive Psychology, 61(1):23–62. 原文条目
-
Juzek and Ward (2025) Thomas Stephan Juzek and Zina B. Ward. 2025. Why does ChatGPT “delve” so much? exploring the sources of lexical overrepresentation in large language models. In Proceedings of the 31st International Conference on Computational Linguistics (COLING 2025), pages 6397–6411. 原文条目
-
Juzek and Ward (2026) Thomas Stephan Juzek and Zina B. Ward. 2026. Word overuse and alignment in large language models: The influence of learning from human feedback. In Machine Learning and Principles and Practice of Knowledge Discovery in Databases (ECML PKDD 2025 Workshops) – 5th Workshop on Bias and Fairness in AI (BIAS 2025), Communications in Computer and Information Science, pages 243–259. Springer Nature Switzerland. Also arXiv:2508.01930. 原文条目
-
Kim and Osterhout (2005) Albert Kim and Lee Osterhout. 2005. The independence of combinatory semantic processing: Evidence from event-related potentials. Journal of Memory and Language, 52(2):205–225. 原文条目
-
Kuperberg (2007) Gina R. Kuperberg. 2007. Neural mechanisms of language comprehension: Challenges to syntax. Brain Research, 1146:23–49. 原文条目
-
Kuribayashi et al. (2022) Tatsuki Kuribayashi, Yohei Oseki, Ana Brassard, and Kentaro Inui. 2022. Context limitations make neural language models more human-like. In Proceedings of the 2022 Conference on Empirical Methods in Natural Language Processing (EMNLP 2022), pages 10421–10436. 原文条目
-
Kwon et al. (2023) Woosuk Kwon, Zhuohan Li, Siyuan Zhuang, Ying Sheng, Lianmin Zheng, Cody Hao Yu, Joseph E. Gonzalez, Hao Zhang, and Ion Stoica. 2023. Efficient memory management for large language model serving with PagedAttention. In Proceedings of the 29th Symposium on Operating Systems Principles (SOSP 2023), pages 611–626. Association for Computing Machinery. 原文条目
-
Lakoff and Johnson (1980) George Lakoff and Mark Johnson. 1980. Metaphors We Live By. University of Chicago Press, Chicago. 原文条目
-
Lambert et al. (2024) Nathan Lambert et al. 2024. Tülu 3: Pushing frontiers in open language model post-training. Preprint, arXiv:2411.15124. 原文条目
-
Lauer (1995) Mark Lauer. 1995. Corpus statistics meet the noun compound: Some empirical results. In 33rd Annual Meeting of the Association for Computational Linguistics, pages 47–54, Cambridge, Massachusetts, USA. Association for Computational Linguistics. 原文条目
-
Levy (2008) Roger Levy. 2008. Expectation-based syntactic comprehension. Cognition, 106(3):1126–1177. 原文条目
-
Levy and Jaeger (2007) Roger Levy and T. Florian Jaeger. 2007. Speakers optimize information density through syntactic reduction. In Advances in Neural Information Processing Systems 19 (NeurIPS 2006), pages 849–856. 原文条目
-
Lewis (1996) Richard L. Lewis. 1996. Interference in short-term memory: The magical number two (or three) in sentence processing. Journal of Psycholinguistic Research, 25(1):93–115. 原文条目
-
Li and Xu (2026) Yongyuan Li and Yang Xu. 2026. Uniform Information Density-Based Preference Optimization. In Third Conference on Language Modeling. 原文条目
-
Lison and Tiedemann (2016) Pierre Lison and Jörg Tiedemann. 2016. OpenSubtitles2016: Extracting large parallel corpora from movie and TV subtitles. In Proceedings of the Tenth International Conference on Language Resources and Evaluation (LREC 2016), pages 923–929, Portorož, Slovenia. European Language Resources Association (ELRA). 原文条目
-
Liu et al. (2025) Zichen Liu, Changyu Chen, Wenjun Li, Penghui Qi, Tianyu Pang, Chao Du, Wee Sun Lee, and Min Lin. 2025. Understanding R1-Zero-like training: A critical perspective. Preprint, arXiv:2503.20783. 原文条目
-
Mak et al. (2006) Willem M. Mak, Wietske Vonk, and Herbert Schriefers. 2006. Animacy in processing relative clauses: The hikers that rocks crush. Journal of Memory and Language, 54(4):466–490. 原文条目
-
Mallinson et al. (2017) Jonathan Mallinson, Rico Sennrich, and Mirella Lapata. 2017. Paraphrasing revisited with neural machine translation. In Proceedings of the 15th Conference of the European Chapter of the Association for Computational Linguistics: Volume 1, Long Papers, pages 881–893, Valencia, Spain. Association for Computational Linguistics. 原文条目
-
Martínez et al. (2022) Eric Martínez, Francis Mollica, and Edward Gibson. 2022. Poor writing, not specialized concepts, drives processing difficulty in legal language. Cognition, 224:105070. 原文条目
-
Meister et al. (2021) Clara Meister, Tiago Pimentel, Patrick Haller, Lena Jäger, Ryan Cotterell, and Roger Levy. 2021. Revisiting the uniform information density hypothesis. In Proceedings of the 2021 Conference on Empirical Methods in Natural Language Processing (EMNLP 2021), pages 963–980. 原文条目
-
Nakov and Hearst (2005) Preslav Nakov and Marti A. Hearst. 2005. Search engine statistics beyond the n-gram: Application to noun compound bracketing. In Proceedings of the Ninth Conference on Computational Natural Language Learning (CoNLL-2005), pages 17–24, Ann Arbor, Michigan. Association for Computational Linguistics. 原文条目
-
NLLB Team (2024) NLLB Team. 2024. Scaling neural machine translation to 200 languages. Nature, 630(8018):841–846. 原文条目
-
Oh and Linzen (2026) Byung-Doh Oh and Tal Linzen. 2026. To model human linguistic prediction, make LLMs less superhuman. Trends in Cognitive Sciences. 原文条目
-
Oh and Schuler (2023) Byung-Doh Oh and William Schuler. 2023. Why does surprisal from larger transformer-based language models provide a poorer fit to human reading times? Transactions of the Association for Computational Linguistics, 11:336–350. 原文条目
-
Oh et al. (2024) Byung-Doh Oh, Shisen Yue, and William Schuler. 2024. Frequency explains the inverse correlation of large language models’ size, training data amount, and surprisal’s fit to reading times. In Proceedings of the 18th Conference of the European Chapter of the Association for Computational Linguistics (EACL 2024), Volume 1: Long Papers, pages 2644–2663. 原文条目
-
Ouyang et al. (2022) Long Ouyang, Jeffrey Wu, Xu Jiang, Diogo Almeida, Carroll Wainwright, Pamela Mishkin, Chong Zhang, Sandhini Agarwal, Katarina Slama, Alex Ray, John Schulman, Jacob Hilton, Fraser Kelton, Luke Miller, Maddie Simens, Amanda Askell, Peter Welinder, Paul F. Christiano, Jan Leike, and Ryan Lowe. 2022. Training language models to follow instructions with human feedback. In Advances in Neural Information Processing Systems 35 (NeurIPS 2022), volume 35, pages 27730–27744. Curran Associates, Inc. 原文条目
-
Padmakumar and He (2024) Vishakh Padmakumar and He He. 2024. Does writing with language models reduce content diversity? In International Conference on Learning Representations. 原文条目
-
Prabhumoye et al. (2018) Shrimai Prabhumoye, Yulia Tsvetkov, Ruslan Salakhutdinov, and Alan W Black. 2018. Style transfer through back-translation. In Proceedings of the 56th Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers), pages 866–876, Melbourne, Australia. Association for Computational Linguistics. 原文条目
-
Rabinovich et al. (2017) Ella Rabinovich, Raj Nath Patel, Shachar Mirkin, Lucia Specia, and Shuly Wintner. 2017. Personalized machine translation: Preserving original author traits. In Proceedings of the 15th Conference of the European Chapter of the Association for Computational Linguistics: Volume 1, Long Papers, pages 1074–1084, Valencia, Spain. Association for Computational Linguistics. 原文条目
-
Reali and Christiansen (2007) Florencia Reali and Morten H. Christiansen. 2007. Processing of relative clauses is made easier by frequency of occurrence. Journal of Memory and Language, 57(1):1–23. 原文条目
-
Reinhart et al. (2025) Alex Reinhart, Ben Markey, Michael Laudenbach, Kachatad Pantusen, Ronald Yurko, Gordon Weinberg, and David West Brown. 2025. Do LLMs write like humans? Variation in grammatical and rhetorical styles. Proceedings of the National Academy of Sciences, 122(8)
. 原文条目 -
Ryan et al. (2024) Michael J. Ryan, William Held, and Diyi Yang. 2024. Unintended impacts of LLM alignment on global representation. In Proceedings of the 62nd Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers), pages 16121–16140. 原文条目
-
Shao et al. (2024) Zhihong Shao, Peiyi Wang, Qihao Zhu, Runxin Xu, Junxiao Song, Xiao Bi, Haowei Zhang, Mingchuan Zhang, Y. K. Li, Y. Wu, and Daya Guo. 2024. DeepSeekMath: Pushing the limits of mathematical reasoning in open language models. Preprint, arXiv:2402.03300. 原文条目
-
Singhal et al. (2024) Prasann Singhal, Tanya Goyal, Jiacheng Xu, and Greg Durrett. 2024. A long way to go: Investigating length correlations in RLHF. In First Conference on Language Modeling (COLM 2024). 原文条目
-
Smith and Levy (2013) Nathaniel J. Smith and Roger Levy. 2013. The effect of word predictability on reading time is logarithmic. Cognition, 128(3):302–319. 原文条目
-
Staub (2010) Adrian Staub. 2010. Eye movements and processing difficulty in object relative clauses. Cognition, 116(1):71–86. 原文条目
-
Staub et al. (2007) Adrian Staub, Keith Rayner, Alexander Pollatsek, Jukka Hyönä, and Helen Majewski. 2007. The time course of plausibility effects on eye movements in reading: Evidence from noun-noun compounds. Journal of Experimental Psychology: Learning, Memory, and Cognition, 33(6):1162–1169. 原文条目
-
Team Olmo et al. (2025) Team Olmo, Allyson Ettinger, Amanda Bertsch, Bailey Kuehl, et al. 2025. Olmo 3. Preprint, arXiv:2512.13961. 原文条目
-
Temperley and Gildea (2018) David Temperley and Daniel Gildea. 2018. Minimizing syntactic dependency lengths: Typological/cognitive universal? Annual Review of Linguistics, 4(1):67–80. 原文条目
-
Thierry et al. (2008) Guillaume Thierry, Clara D. Martin, Victorina Gonzalez-Diaz, Roozbeh Rezaie, Neil Roberts, and Philip M. Davis. 2008. Event-related potential characterisation of the Shakespearean functional shift in narrative sentence structure. NeuroImage, 40(2):923–931. 原文条目
-
Trueswell et al. (1994) John C. Trueswell, Michael K. Tanenhaus, and Susan M. Garnsey. 1994. Semantic influences on parsing: Use of thematic role information in syntactic ambiguity resolution. Journal of Memory and Language, 33(3):285–318. 原文条目
-
University of Waterloo (2026) University of Waterloo. 2026. Q and a with the experts: What is “Claudish”? University of Waterloo News. Accessed 2026-09-15. 原文条目
-
Vanmassenhove et al. (2021) Eva Vanmassenhove, Dimitar Shterionov, and Matthew Gwilliam. 2021. Machine translationese: Effects of algorithmic bias on linguistic complexity in machine translation. In Proceedings of the 16th Conference of the European Chapter of the Association for Computational Linguistics: Main Volume, pages 2203–2213, Online. Association for Computational Linguistics. 原文条目
-
Vanmassenhove et al. (2019) Eva Vanmassenhove, Dimitar Shterionov, and Andy Way. 2019. Lost in translation: Loss and decay of linguistic richness in machine translation. In Proceedings of Machine Translation Summit XVII: Research Track, pages 222–232, Dublin, Ireland. European Association for Machine Translation. 原文条目
-
Vaswani et al. (2017) Ashish Vaswani, Noam Shazeer, Niki Parmar, Jakob Uszkoreit, Llion Jones, Aidan N Gomez, Łukasz Kaiser, and Illia Polosukhin. 2017. Attention is All you Need. In Advances in Neural Information Processing Systems, volume 30. Curran Associates, Inc. 原文条目
-
Wieting and Gimpel (2018) John Wieting and Kevin Gimpel. 2018. ParaNMT-50M: Pushing the limits of paraphrastic sentence embeddings with millions of machine translations. In Proceedings of the 56th Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers), pages 451–462, Melbourne, Australia. Association for Computational Linguistics. 原文条目
-
Xu et al. (2026) Weijie Xu, Brian Dillon, and Richard Futrell. 2026. Memory efficiency and resource-rational encoding in sentence processing. In Proceedings of the 64th Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers), pages 33603–33618, San Diego, California, United States. Association for Computational Linguistics. 原文条目
-
Yang et al. (2024) An Yang, Baosong Yang, Beichen Zhang, Binyuan Hui, Bo Zheng, Bowen Yu, et al. 2024. Qwen2.5 technical report. Preprint, arXiv:2412.15115. 原文条目
署名与许可
原论文:Thomas Hikaru Clark、Matias B. Martin、Kyle Mahowald,2026,Why is AI-generated language so hard to understand?,arXiv:2610.29162v1,采用 CC BY 4.0 许可。
本站中文翻译由 AI 辅助完成,并依原文整理排版。译文保留作者论证中的推测和限制;英语例句、公式、书目信息和图内标签保留必要原文。原图沿用原作者署名与许可,图注已译为中文,图 8 的提示文字改为可复制文本。翻译与改编部分同以 CC BY 4.0 提供。文末的 AGENTS.md 规则是根据用户提供的写作建议与论文启发整理的实践文本,不应引用为论文已经验证的中文规范。
留下你的声音
聊一聊
无需登录,填写昵称即可留言。评论和昵称会公开显示,邮箱不会公开。
这里是本地测试评论区,留言不会混入正式页面。